Veritas·RAG
Framework open source d’évaluation RAG : trois stratégies de retrieval sur un même corpus, notées par un LLM juge, avec détection de régressions entre les exécutions.
Le problème : évaluer un RAG en production
Un système RAG est difficile à évaluer : une optimisation qui semble meilleure en test peut dégrader les réponses sur de vraies questions. La plupart des équipes évaluent à la main, ou avec des métriques de précision qui ignorent la latence, le coût en tokens et les hallucinations.
La solution : un pipeline d’évaluation
Fonctionnement
Couche ingestion : parsers PDF, DOCX, PPTX, HTML, e-mail et documents scannés (OCR), chunking qui coupe d’abord aux titres et ne coupe jamais une ligne de tableau, métadonnées de droits d’accès sur chaque chunk. Recharger un fichier inchangé est idempotent.
Couche retrieval : trois stratégies interchangeables.
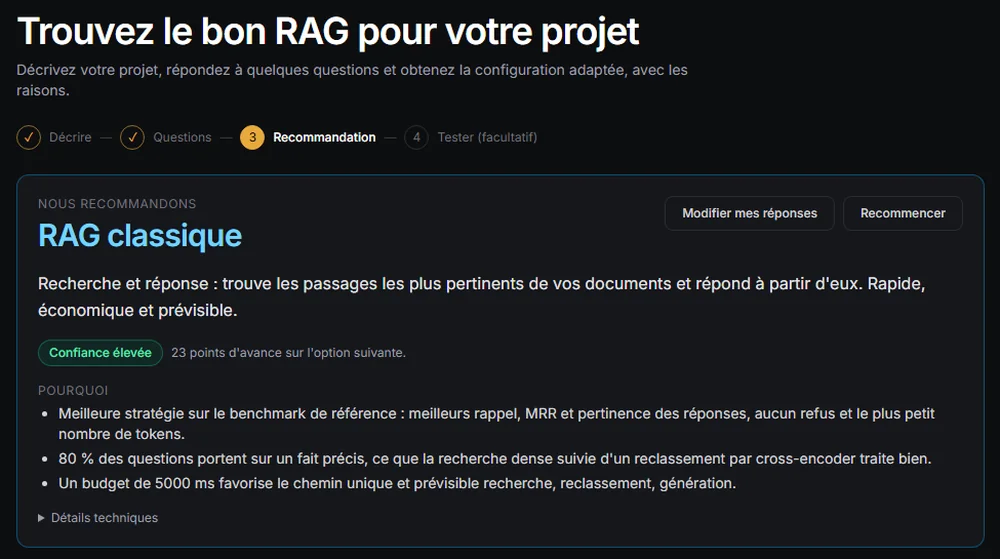
- Classique : recherche hybride (dense dans Qdrant + BM25, fusion RRF), puis reranking par cross-encoder ; repli BM25 si le reranker échoue, signalé dans chaque réponse.
- Graphe : parcours de triplets d’entités extraits du corpus par Claude.
- Agentique : Claude pilote en boucle des outils search, fetch et finish.
- Les trois implémentent une interface commune (design pattern Strategy) et renvoient le même format de résultat : on les interchange par configuration et on les compare question par question.
Évaluation
- LLM juge (Claude) : fidélité, pertinence de la réponse, précision et rappel du contexte, et exactitude quand une réponse de référence existe.
- Métriques de retrieval : précision, rappel, hit rate, MRR.
- Détection de régressions entre deux exécutions d’une même configuration.
- Jeux de questions de référence en anglais et en français.
Conçu comme un produit
- RGPD : masquage des données personnelles, effacement, export et rétention, journal d’audit, SSO OIDC et contrôle d’accès.
- Observabilité : traces Langfuse (spans de génération et d’appels d’outils, par stratégie), Prometheus et Grafana.
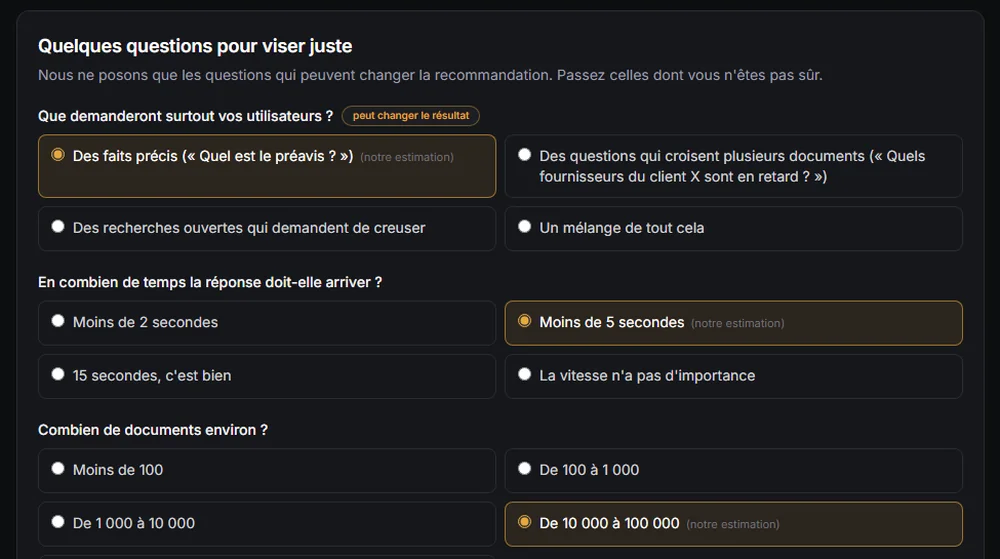
- Interface React : vues Ask, Compare, Advisor, Eval et Regressions, en français et en anglais.
- CI/CD GitHub Actions : ruff, mypy, pytest avec couverture, pip-audit, lint, typage, tests et build du front, build des images Docker.
Résultats : baseline mesurée
34 questions de référence sur le corpus fourni (41 documents, 107 chunks), mesurées le 08/09/2026 sur le pipeline dense-only, juste après la correction du reranker (voir ci-dessous). Un nouveau baseline sur le pipeline hybride est en cours.
| Métrique | Classique | Graphe | Agentique |
|---|---|---|---|
| Rappel du retrieval | 0,765 | 0,765 | 0,544 |
| MRR | 0,554 | 0,554 | 0,356 |
| Fidélité | 0,507 | 0,519 | 0,249 |
| Pertinence de la réponse | 0,862 | 0,854 | 0,521 |
| Latence par question | 21,7 s | 15,2 s | 18,0 s |
| Tokens (total) | 389k | 397k | 727k |
- Sur ce corpus, le retrieval par graphe égale la qualité du classique avec 30 % de latence en moins.
- La stratégie agentique consomme 1,9× plus de tokens pour une qualité de retrieval plus faible, et refuse de répondre à 6 questions.
- Aucune stratégie ne gagne partout : l’outil sert à mesurer sur ses propres données avant de livrer.
Ce que l’évaluation a révélé
Les premiers scores du LLM juge étaient bas alors que tout répondait HTTP 200. En remontant le pipeline, j’ai trouvé un identifiant de modèle erroné : le cross-encoder ne se chargeait jamais, et le système retombait silencieusement sur BM25. Dans le même passage : un index qui contenait deux fois le corpus. Après correction, chaque réponse indique le reranker réellement utilisé, et le modèle fait partie de la configuration comparée par la détection de régressions, pour qu’un run dégradé ne soit jamais comparé à un run sain.
Stack technique
 Python
 FastAPI
 Pydantic
 Claude APIQdrant
 sentence-transformersBM25
 PostgreSQL
 React
 TypeScript
 Docker
 GitHub ActionsLangfuse
 Prometheus
 Grafana